Claude ne sait pas générer d'images : le titre de cet article triche un peu. Mais un assistant de code qui dispose d'un terminal ne se limite pas à ce qu'il sait faire seul. Il peut installer et piloter un outil qui, lui, sait le faire.
Les illustrations de ce site ont été générées au fil des articles et de la précédente refonte, avec Gemini, sans direction artistique commune. Après la refonte visuelle du site vers un style « plan d'ingénieur », papier et encre, elles juraient avec tout le reste : deux styles incompatibles, du texte incrusté, et sur certaines le filigrane du générateur dans un coin. Il fallait les refaire, toutes, sans perdre ce que chacune racontait.
J'ai étudié ce qu'il était possible de faire en local, établi un plan, cadré le travail et préparé une station de travail vierge. L'exécution, je l'ai confiée à Claude, par SSH : il y a installé ComfyUI et un modèle d'édition d'image open source, Qwen-Image-Edit-2511, et 111 illustrations ont été redessinées en une heure de calcul environ, sans qu'une seule image quitte le réseau local. Cet article raconte le montage et ses risques, les échecs matériels, ce que le modèle sait faire ou non, et ce que l'opération a réellement coûté.
Pourquoi refaire 111 illustrations
Le point de départ comptait environ 130 illustrations : couvertures d'articles, pages de villes, services, modèles d'engagement, guides. Elles mélangeaient au moins deux familles visuelles. D'un côté, des vues isométriques en aplats froids, gris et bleus. De l'autre, des scènes illustrées aux tons sépia, baignées d'une lumière dorée. Prises une par une, aucune n'était mauvaise. Côte à côte sur une page de liste, elles donnaient l'impression d'un site assemblé par morceaux.
Pendant un temps, un filtre CSS global passait toutes les images en noir et blanc. Il masquait l'écart de palette, pas l'écart de style : une scène sépia en niveaux de gris reste une scène sépia, et une isométrie reste une isométrie. Trois défauts restaient visibles :
- le filigrane — certaines images portaient l'étoile de Gemini dans le coin inférieur droit
- le texte incrusté — enseignes de café, titres de diapositive, nuages marqués « SaaS ». Un générateur d'images écrit approximativement, et un mot mal orthographié sur une couverture se remarque plus que n'importe quel trait
- le style « fait par IA » — lumière dorée, personnages souriants, profusion de détails : exactement ce que la refonte cherchait à quitter
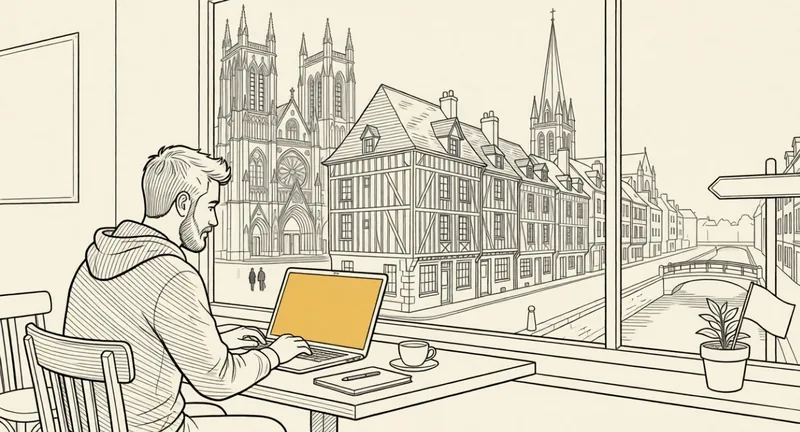
La cible a été fixée après quelques essais : un dessin technique à l'encre noire, d'épaisseur régulière, sur un papier blanc cassé, des hachures légères pour les ombres, aucun dégradé, et un seul objet clé rempli d'un aplat ambre, la couleur d'accent du site. Et aucun texte. Une première cible, plus proche d'une illustration vectorielle plate en ardoise et indigo, a été essayée puis abandonnée : elle corrigeait l'incohérence sans donner d'identité.
Point essentiel : il ne s'agissait pas de générer de nouvelles images, mais de redessiner les existantes. Chaque illustration avait été choisie pour son article ; la scène, les personnages et la composition devaient rester. C'est un travail d'édition d'image, pas de génération à partir d'un texte.
Avant — Gemini
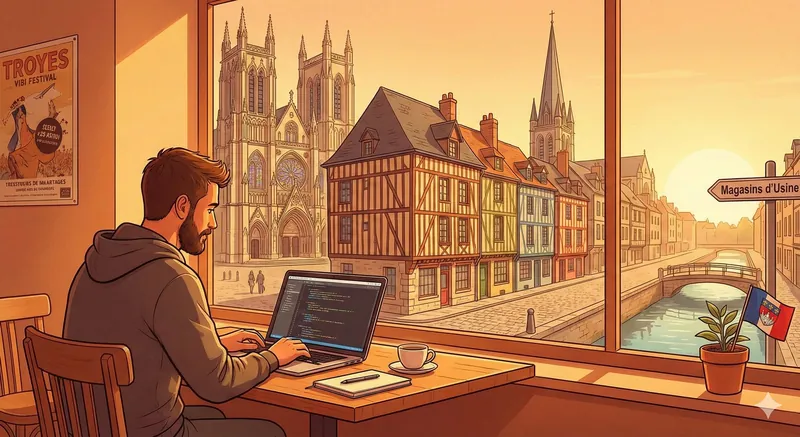
Après — Qwen-Image-Edit-2511
Une machine vierge, un plan et Claude à l'exécution
Le montage est simple. Claude tourne sur mon portable de développement. La station de travail équipée du GPU est sur le même réseau local, et seule une connexion SSH les relie. J'ai préparé la station pour ce rôle : un système fraîchement installé, un compte avec sudo sans mot de passe, la clé SSH du portable, et rien d'autre. Avant la première commande, le travail était cadré : ce qu'il fallait obtenir, la chaîne envisagée, les étapes et la façon de vérifier chacune.
L'exécution est ensuite passée par SSH, et par SCP pour les fichiers :
- l'installation — le pilote NVIDIA, Docker et l'accès au GPU depuis les conteneurs
- l'empaquetage — l'image Docker de ComfyUI décrite plus bas, avec ses versions épinglées
- les modèles — environ 23 Go téléchargés directement sur la station, vérifiés avant usage
- les rendus — les originaux envoyés sur la station, le rendu lancé à distance, puis les grilles de comparaison rapatriées sur le portable
Pourquoi ce niveau d'accès était acceptable
Un sudo sans mot de passe confié à un assistant IA, c'est précisément ce que je déconseillerais sur un poste de travail ou un serveur. Ici, la machine ne contenait rien : ni données, ni secrets, ni accès à la production. Le pire scénario était de la réinstaller. C'est un bac à sable, pas une délégation de confiance.
La station n'a été reliée à internet que le temps de télécharger les paquets système, les bibliothèques et les modèles. Elle en a ensuite été coupée, et n'est restée joignable que depuis le réseau local. Claude, lui, tourne sur le portable : la station n'a pas besoin d'internet pour travailler. Même compromise, elle n'aurait eu ni données à exfiltrer, ni accès à l'extérieur.
C'est le raisonnement que je défends pour tout accès donné à une IA dans un système d'information : la question n'est pas de savoir si l'on fait confiance à l'assistant, mais ce qu'il peut atteindre. Sur une machine dédiée et jetable, la réponse est « rien qui compte », et l'assistant peut travailler sans demander la permission à chaque commande.
Qui a fait quoi
La répartition ressemble à celle d'un chantier mené avec un développeur très rapide. De mon côté : l'analyse de ce qui était faisable, le plan, le cadrage, la préparation de la station et le style visé. Puis toutes les décisions : les pistes à abandonner, le moment de lancer le lot complet, et la relecture des 111 images avant qu'elles ne remplacent quoi que ce soit dans le dépôt du site. Du côté de Claude : l'installation, l'empaquetage, les rendus et les allers-retours de fichiers. Il proposait aussi des essais, sur lesquels nous avons itéré à partir des grilles que j'examinais.
Claude n'a pas remplacé le travail d'ingénierie : il en a absorbé l'exécution.
Pourquoi en local plutôt qu'une API
Les services en ligne savent faire ce genre de retouche. J'ai pourtant choisi de tout faire tourner sur mes machines, pour trois raisons.
- le coût d'itération — une API se paie à l'image produite. Or la mise au point d'un style consiste précisément à produire beaucoup d'images qu'on jette : variantes de consigne, changements de graine, comparaisons de modèles. En local, un essai raté ne coûte que quelques dizaines de secondes
-
la confidentialité — ici, les images étaient publiques. Mais la même chaîne sert à retoucher
des maquettes ou des captures qui ne le sont pas. Une fois les modèles téléchargés, tout fonctionne hors ligne :
la station a été coupée d'internet, et le service n'écoute que sur
127.0.0.1 - la reproductibilité — un modèle versionné, une image Docker épinglée, une consigne écrite dans un script et une graine fixée par le script de rendu : dans six mois, une nouvelle illustration sortira dans le même style. Un service en ligne peut changer de modèle du jour au lendemain, sans prévenir
Le raisonnement rejoint celui que je détaille sur le coût réel d'une fonctionnalité IA : le prix unitaire d'un appel n'est qu'un poste parmi d'autres. Pour un traitement par lots, relancé à chaque nouvelle illustration, la vraie question est de savoir qui maîtrise le modèle et sa version.
La stack et le matériel, échecs compris
Une image Docker épinglée
ComfyUI est une interface à base de graphes de nœuds pour les modèles de diffusion. Elle expose aussi une API HTTP, ce qui permet de soumettre un graphe depuis un script. Elle est empaquetée dans une image Docker : ComfyUI v0.38.0, l'extension ComfyUI-GGUF épinglée sur un commit, PyTorch installé depuis un index choisi selon la carte graphique. Deux fichiers Compose de surcharge, l'un pour ROCm (AMD), l'autre pour CUDA (NVIDIA), ne changent que l'index PyTorch et l'accès au GPU.
services:
  comfyui:
    build: .
    ports:
      - "127.0.0.1:8188:8188"
    volumes:
      - ./models:/opt/ComfyUI/models
      - ./input:/opt/ComfyUI/input
      - ./output:/opt/ComfyUI/output
      - ./workflows:/opt/ComfyUI/workflows
Les modèles vivent dans un volume, hors de l'image : environ 23 Go pour la chaîne d'édition.
Le modèle de diffusion Qwen-Image-Edit-2511 est utilisé en version quantifiée GGUF Q4_K_S (12,4 Go),
accompagné de son encodeur de texte Qwen2.5-VL 7B en FP8 (9,4 Go), du VAE, et d'un LoRA « Lightning »
qui ramène l'échantillonnage à 4 étapes au lieu de 20 à 40. Chaque fichier a été vérifié par sa taille,
et le GGUF par son empreinte SHA-256.
L'iGPU qui se fait tuer
Avant la station, j'ai fait les premiers essais moi-même, avec Claude pour m'orienter dans la documentation, sur mon portable de développement : un Ryzen AI 9 HX 370 avec un iGPU Radeon 890M. Sur le papier, l'idée se défend : l'iGPU n'a pas de mémoire dédiée, il partage la mémoire système, jusqu'à 16 Go environ. En pratique, l'image ROCm a mis une cinquantaine de minutes à se construire, le dépôt des paquets ROCm tombant par moments à quelques kilo-octets par seconde. Puis le premier rendu a été tué par le noyau, faute de mémoire, au moment où le modèle de diffusion se chargeait par-dessus l'encodeur de texte : la « VRAM » de l'iGPU, c'est la RAM déjà occupée par les autres environnements de développement.
Une carte de 12 Go, et un débordement assumé
La machine retenue est une station de travail portable équipée d'une NVIDIA RTX 3500 Ada à 12 Go de mémoire vidéo. Même là, le modèle quantifié ne tient pas entièrement : environ 2,5 Go sont déchargés en mémoire centrale. Le rendu fonctionne, en 62 secondes à froid et 48 secondes à chaud pour une image de 1248×832.
J'ai alors essayé une quantification plus agressive, Q3_K_M (9,9 Go), en pensant gagner du temps.
Ce n'est pas le cas : environ 60 secondes, pour un rendu moins fidèle. Le temps ne part pas dans le calcul,
mais dans le va-et-vient, à chaque image, entre l'encodeur de texte et le modèle de diffusion,
qui ne tiennent pas ensemble en mémoire vidéo. Réduire l'un des deux ne supprime pas ce va-et-vient.
Ce qui marche, ce qui ne marche pas
Avant de lancer quoi que ce soit en masse, nous avons testé, Claude et moi, trois images choisies pour leurs difficultés : une scène de réunion sépia avec un titre de diapositive, une terrasse de café avec enseignes et vue sur une cathédrale, une isométrie froide avec un nuage marqué « SaaS ». Chaque essai produisait une grille de comparaison, côte à côte.
La consigne seule bat l'image de référence
Intuitivement, la meilleure façon de transmettre un style est de le montrer. Le modèle accepte plusieurs images en entrée : j'ai donc d'abord fourni l'image à transformer, accompagnée d'une illustration de référence dans le style voulu. Résultat : le modèle copie le contenu de la référence, pas seulement son style. Sur l'isométrie « SaaS », la scène entière a été remplacée par celle de la référence.
Décrire le style par écrit, sans image de référence, conserve la composition et donne un meilleur rendu, en 44 secondes environ. C'est contre-intuitif, mais cohérent avec ce qu'on attend d'un modèle d'édition : il suit une instruction, et une seconde image devient pour lui un matériau à utiliser.
La suppression du texte fonctionne
Demander explicitement de retirer tout texte, chiffre et logo, et de laisser enseignes, écrans et badges vierges, a fonctionné sur toutes les images testées. Le titre de diapositive devient une bande vide, l'enseigne du café une marquise nue, le nuage « SaaS » une forme sans inscription. Le filigrane disparaît dans le même mouvement, puisque l'image est entièrement redessinée.
Une image à la fois
Les retouches sur une seule image sont fiables : « retire la tasse de café, ne change rien d'autre » retire la tasse et ne change rien d'autre. Les combinaisons de deux images, en revanche, dépendent de la graine : certaines variantes réussissent, d'autres renvoient l'une des deux images presque telle quelle. À trois images, le modèle mélange les personnages. Pour un travail en série, je n'ai retenu que l'édition d'une image unique.
La génération à partir d'un texte ne remplace pas l'édition
J'ai aussi testé le modèle de génération à partir d'un texte seul, Qwen-Image-2512, pour créer de nouvelles illustrations. Il fonctionne, en 35 secondes environ, mais il reste trop détaillé et trop réaliste, même avec une consigne insistante sur le style plat et minimaliste. Il ne connaît pas non plus les monuments locaux : la cathédrale de Troyes sort sous les traits d'une cathédrale gothique générique. Et la consigne « pas de logo » n'est pas toujours respectée. Pour une nouvelle illustration, la chaîne la plus sûre reste de générer une scène, puis de la faire passer par la même édition que les autres.
Le style n'est pas une loi
Même sur le lot final, le modèle interprète la consigne. « Un seul objet en ambre » devient parfois deux ou trois zones ambrées sur une même image. Le résultat reste cohérent à l'échelle du site, mais il ne faut pas attendre d'un modèle d'édition l'obéissance d'un filtre : c'est une contrainte de plus pour la relecture humaine.
Cette prudence vaut pour tous les usages de l'IA générative. Comme je l'écrivais après six mois d'usage d'un assistant de code, le travail ne disparaît pas avec l'IA : il se déplace vers la relecture de ce qu'elle produit.
Industrialiser : une consigne, un lot reprenable, une relecture
Une fois la consigne mise au point sur quelques images représentatives, le passage à l'échelle tient en un script court. Trois principes le guident.
- une consigne unique, versionnée — la description du style et la liste de ce qu'il faut conserver sont écrites une fois, dans le script. Toute nouvelle illustration du site passe par la même consigne
- un lot reprenable — le script saute les images déjà produites. Une coupure, un échec, une mise en veille : on relance, il reprend où il en était
- une sortie séparée — les résultats arrivent dans un dossier à part, jamais directement dans le dépôt du site. Rien ne remplace une illustration tant qu'elle n'a pas été regardée
#!/usr/bin/env bash
STYLE="Redraw image 1 as a technical pen-and-ink line illustration, like an engineer's sketchbook drawing: fine black ink lines of even weight on plain warm off-white paper, light cross-hatching for shading, no gradients, no glow. Everything is black ink on paper except one key object, filled with a single flat warm amber yellow. "
KEEP="Keep the same scene, characters, poses, objects and composition of image 1. Remove all text, letters, numbers and logos: leave signs, screens, labels and badges blank or fill them with simple abstract shapes."

for f in input/batch/*.jpg; do
  name=$(basename "$f" .jpg)
  ls output/batch/"$name"_* >/dev/null 2>&1 && continue
  echo "== $name"
  docker compose exec -T comfyui python workflows/run.py "batch/$name.jpg" --prompt "$STYLE$KEEP" --prefix "batch/$name" || echo "FAILED $name"
done
La consigne est en anglais : le modèle comprend surtout l'anglais et le chinois ; en français, les résultats sont moins bons. Elle est construite comme une instruction, pas comme une description : ce qu'il faut changer, puis ce qu'il faut garder. Sans la seconde partie, le modèle s'autorise à retoucher la scène.
Les originaux sont préparés avant l'envoi : convertis en JPEG et ramenés à 1 600 pixels de large, nommés d'après leur dossier d'origine pour pouvoir les remettre en place. Le modèle travaille autour d'un mégapixel ; le site régénère ensuite ses propres variantes de 400, 800 et 1 200 pixels avec sa commande d'optimisation d'images. Les captures d'écran d'applications, les photos et les logos sont exclus : ce ne sont pas des illustrations.
Le lot complet a traité 111 images, à 32 secondes environ par image, soit à peu près une heure de calcul. C'est moins que les 44 à 48 secondes mesurées pendant les essais sur une image isolée, sans que j'en aie établi la cause. Aucun échec technique, et toutes ont été acceptées à la relecture, ce qui est plus que je n'espérais. La relecture n'en reste pas moins l'étape qui donne sa valeur au reste : c'est elle qui autorise à remplacer 111 fichiers d'un coup dans le dépôt, en un seul commit facile à annuler.
Ce que ça a réellement coûté
Le calcul en lui-même est presque gratuit : une heure de GPU sur une machine déjà disponible. Le coût réel est ailleurs, et il est surtout fait de temps.
| Étape | Ce qu'elle a demandé |
|---|---|
| Installation | Pilote NVIDIA, accès GPU pour Docker, construction de l'image et environ 23 Go de modèles, le tout exécuté par Claude à distance, selon le plan établi |
| Fausse piste matérielle | Une cinquantaine de minutes de construction ROCm, pour un rendu tué faute de mémoire |
| Mise au point | Comparaisons de quantifications, avec et sans référence, deux styles cibles, de 44 à 62 s par rendu |
| Lot final | 111 images à 32 s environ, soit une heure, sans surveillance |
| Relecture et intégration | Revue image par image, régénération des variantes, un commit |
Face à une API facturée à l'image, le calcul brut du lot final pèserait peu dans un sens comme dans l'autre. La différence se joue sur la mise au point, qui consomme bien plus d'images que le lot lui-même, et sur la suite : chaque nouvel article recevra une illustration passée par la même consigne, sur la même version du modèle, sans abonnement ni dépendance à un service qui peut évoluer. En contrepartie, il faut le matériel : une carte de 12 Go est un minimum confortable pour ce modèle quantifié, et une machine sans GPU dédié n'a pas suffi.
Le choix ressemble à celui qu'on fait pour toute brique d'IA : avant d'adapter un modèle, on épuise ce que permet la consigne. C'est la logique que je décris dans le guide de décision entre RAG, fine-tuning et prompt engineering : ici, aucun entraînement n'a été nécessaire, une consigne bien écrite a suffi. Les pistes suivantes — un LoRA de style pour la génération, l'encodage de toutes les consignes avant le lot pour éviter les échanges en mémoire vidéo — n'auront de sens que si la consigne seule atteint ses limites.
Conclusion
Redessiner un fonds d'illustrations hétérogène n'est plus un chantier de graphiste de plusieurs semaines, ni un abonnement à un service en ligne. Un modèle d'édition open source, une carte graphique de 12 Go, une consigne écrite avec soin et un script reprenable suffisent pour une centaine d'images en une heure. Et l'assistant qui ne sait pas générer d'images en a exécuté le montage, dans un cadre fixé à l'avance et sur une machine où il ne pouvait rien casser d'important. Le reste du travail est de l'ingénierie ordinaire : épingler les versions, mesurer avant d'optimiser, écarter les fausses bonnes idées comme l'image de référence, et ne rien remplacer sans l'avoir regardé.
Message clé
En IA générative, la valeur n'est pas dans le modèle mais dans la chaîne : une version figée, une consigne versionnée, un lot reprenable et une relecture humaine.
Vous envisagez d'intégrer un modèle d'IA, en local ou via une API, dans vos processus ? Je vous aide à cadrer et industrialiser l'intégration. Parlons-en.