Aller au contenu principal

Articles

Blog — Architecture web, Symfony et DevOps

Retrouvez mes réflexions sur l'ingénierie logicielle, les meilleures pratiques et l'actualité tech.

59 articles · page 1/5

Décideurs · Prestataires · · 12 min

Prestataire web au Luxembourg : agence locale ou consultant frontalier ?

Une entreprise luxembourgeoise qui lance un projet d'application web tranche souvent trop vite entre une agence web locale et un consultant senior indépendant basé en France. Cet article compare les deux modèles honnêtement, critère par critère : la proximité et les déplacements (le Grand-Duché est à une ou deux heures de bassins frontaliers denses, un modèle hybride couvre les temps forts), l'accès direct à l'ingénieur sans intermédiaire ni sous-traitance, l'expertise senior face aux équipes mixtes en séniorité, une structure de coûts plus légère depuis la France sans afficher de prix, la TVA intracommunautaire autoliquidée entre deux États membres, et le bilinguisme français/anglais. Il précise aussi, par honnêteté, quand une agence locale reste le meilleur choix : besoin d'une équipe pluridisciplinaire, présence physique quasi quotidienne, continuité de service formalisée ou volume important et durable. La conclusion : ne pas choisir un statut, mais l'adéquation entre un modèle et un besoin.
Décideurs · Sécurité · Stratégie · · 13 min

Application web fintech au Luxembourg : les exigences CSSF

Concevoir une application web pour le secteur financier luxembourgeois ne se résume pas à livrer un logiciel : c'est intégrer, dès l'architecture, des exigences de traçabilité, de contrôle des accès et de conformité qui structurent tous les choix techniques. Cet article détaille le contexte réglementaire (la CSSF supervise le secteur, l'externalisation IT ne transfère pas la responsabilité de l'entité, statuts PSF de support), puis les exigences concrètes dans le code et l'infrastructure : journalisation métier immuable, gestion fine des accès au moindre privilège, chiffrement en transit et au repos, minimisation des données et conformité RGPD supervisée par la CNPD, hébergement et souveraineté. Il montre enfin pourquoi un héritage issu d'environnements réglementés change la façon d'aborder ce type de projet : penser un système par ses garanties, le documenter pour un audit, et le livrer avec son code source pour préserver l'autonomie et la conformité du client.

Technique · IA · Développement · · 14 min

6 mois avec Claude Code : ce sur quoi je m'étais trompé

Suite directe du retour d'expérience de janvier sur la refonte de x10-solutions.fr, qui se concluait sur un scepticisme assumé : « je n'envisage pas que des agents Claude puissent générer l'intégralité de l'application ». Six mois plus tard, cet article est un mea culpa argumenté et chiffré à partir du dépôt Git du site : 280 commits, plus de 81 500 lignes ajoutées, un blog passé de moins de dix articles à 58, un glossaire de 165 termes. La chronologie explique l'erreur — janvier en prise en main (6 commits), février consacré à l'industrialisation (85), mars et la suite en production continue (120). Trois raisons ont renversé le verdict, et une seule tient au modèle : le contexte est devenu un artefact versionné du dépôt plutôt qu'une conversation chez un éditeur, et j'avais jugé un outil que je ne savais pas encore utiliser. Le ratio s'est inversé (80 % de génération, 20 % de relecture), le budget outillage a triplé pour un arbitrage trivial, et Stitch a disparu du circuit. Mais la thèse de janvier tient sur l'essentiel : le gain vient de l'expertise qui cadre et relit. La démonstration est arrivée par surprise — des clients passés à Claude Code envoient désormais des merge requests, issues et specs générées par IA : massives, verbeuses, souvent fausses, et la charge de tri se déplace sur le prestataire. Le même outil multiplie le débit chez qui sait juger, et le volume à trier chez qui ne sait pas.

Technique · Sécurité · IA · · 12 min

Pentest automatisé par IA : le vrai coût d'une campagne multi-agents

Peut-on confier un test d'intrusion à des agents IA autonomes, et à quel coût réel ? Cet article est un retour d'expérience chiffré sur Shannon, un pentesteur IA autonome open source, lors d'une campagne multi-agents menée en mode exploitation active sur un périmètre de test — cinq classes de failles applicatives couvrant l'essentiel du Top 10 OWASP. Il décompose le coût poste par poste et révèle que l'exploitation concentre plus de la moitié de la dépense et du temps, distingue le coût « équivalent API » du coût réellement payé sous abonnement forfaitaire (proche de zéro, la vraie ressource étant le budget de session), et explique l'écart entre horloge murale et temps cumulé dû au parallélisme des agents. Il détaille surtout les limites : distinguer une faille du code d'un artefact déposé, ne pas confondre « non exploité » et « non exploitable », et transformer une liste de vulnérabilités en plan de remédiation priorisé — autant de jugements qui restent humains. Enfin, il rappelle pourquoi un rapport de pentest ne se publie jamais : la divulgation responsable prime.

Décideurs · IA · Budget · · 15 min

Combien coûte réellement une fonctionnalité IA

Le coût réel d'une fonctionnalité IA n'a presque rien à voir avec le prix du token, sur lequel se focalisent la plupart des décideurs. Cet article décompose les cinq postes qui composent réellement la facture : l'inférence (avec les ordres de grandeur des tarifs publics des modèles et l'écart de facteur 30 entre gammes), l'infrastructure (base vectorielle, orchestration, souveraineté), la fiabilisation (évaluations, garde-fous, validation humaine — le poste le plus sous-estimé), l'intégration au système d'information et la maintenance face à la dérive des modèles. Il détaille les erreurs qui font exploser le budget, compare les trajectoires API, sur mesure et SaaS, et donne une méthode pour chiffrer et maîtriser un projet IA : cadrer le cas d'usage, prototyper et mesurer avant l'échelle, choisir le plus petit modèle qui répond au besoin, et budgéter la fiabilisation dès le départ.

Technique · IA · Sécurité · · 15 min

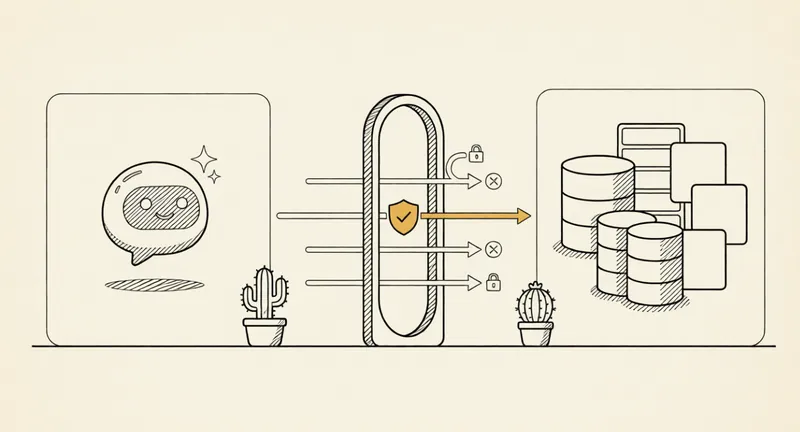
Enfermer une IA dans une API dédiée avec MCP

Brancher un assistant IA sur le système d'information est aussi puissant que risqué : un modèle non déterministe, potentiellement manipulable, ne devrait jamais recevoir un accès direct au SI. Cet article détaille une approche éprouvée pour l'en empêcher — construire une API dédiée, taillée sur mesure, qui sert de sas entre l'IA et le SI. Chaque opération autorisée y devient un outil MCP, la documentation OpenAPI soignée sert de contexte au modèle, et le protocole MCP prend le relais pour la découverte et l'appel. L'article explique pourquoi API Platform rend ce montage naturel (déclaratif, OpenAPI de première classe, sécurité intégrée, ouverture MCP), ce que le sas garantit concrètement (moindre privilège, surface réduite, validation, authentification, quotas, journalisation, découplage), et surtout ce qu'il ne règle pas : injection de prompt, mésusage d'une opération permise, non-déterminisme. Un parti pris assumé : on ne sécurise pas une IA en lui faisant confiance, on la connecte à travers une API qui décide, opération par opération, ce qui passe.

Technique · Méthodologie · IA · · 13 min

Un plugin Claude Code pour les conventions de toute l'équipe

Guider un assistant de code comme Claude Code se fait au contexte : conventions de nommage, règles de style, recettes pour ouvrir une MR ou répondre à une review. Le réflexe est d'écrire tout cela dans un CLAUDE.md par projet — et de le dupliquer, désynchronisé, sur des dizaines de dépôts. Ce retour d'expérience, tiré d'un éditeur SaaS aux nombreux repos frères, décrit une autre voie : packager le workflow de l'équipe dans un plugin Claude Code interne, versionné et distribué comme une dépendance via un marketplace privé. Commandes git/Jira/GitLab, règles transverses (style, sécurité, dimensions de review), agents, hooks de vérification d'environnement — aucun secret dans le plugin, seulement des vérifications : tout vit à un seul endroit et tous les repos en héritent. L'article revient au passage sur un malentendu fréquent — croire qu'une doc humaine (README, wiki) suffit à l'assistant, alors que doc humaine et doc pour l'assistant servent deux publics et appellent deux formats différents. Il détaille ce qu'on y met, pourquoi la source unique de vérité et le cycle de vie découplé changent la donne pour l'onboarding et la cohérence des reviews, et les limites — coût de maintenance, risque de fourre-tout, adoption d'équipe — pour ne pas sur-outiller.

Décideurs · Architecture · Stratégie · · 11 min

Comment fonctionne une synchronisation ERP ↔ e-commerce

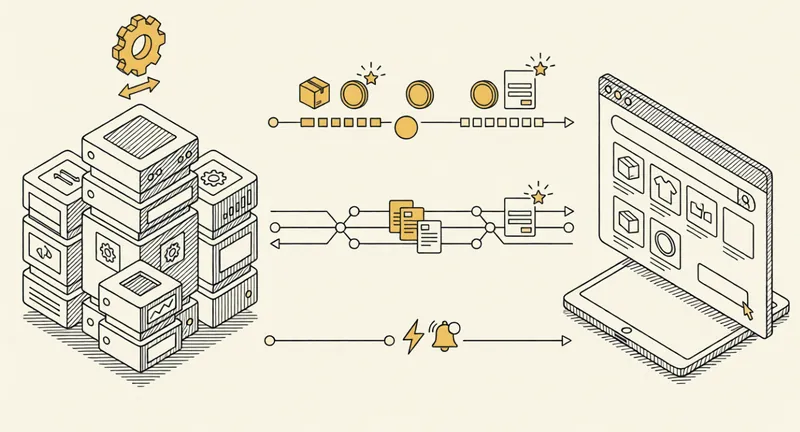
Connecter un ERP à un site e-commerce paraît simple vu de loin : « il suffit de synchroniser les stocks ». En pratique, c'est une architecture à part entière — trois patterns d'intégration (push, pull, event-driven), une gestion fine des deltas, des reprises sur incident et des règles métier qui débordent toujours du standard. Cet article explique comment fonctionne réellement une synchronisation ERP ↔ e-commerce, quels pièges guettent (surventes, doublons, casse silencieuse) et comment cadrer et chiffrer un projet d'intégration sans mauvaise surprise.

Technique · Architecture · · 15 min

Application multi-tenant : quel modèle d'isolation ?

Concevoir une application SaaS impose tôt une décision structurante : comment isoler les données de chaque client. Cet article compare les quatre modèles multi-tenant, du plus mutualisé au plus cloisonné — base partagée avec discriminant tenant_id, schéma par client, base par client (silo) et instance par client. Pour chacun, les vrais arbitrages : cloisonnement et risque de fuite, RGPD, coût d'infrastructure et de migrations, noisy neighbor, personnalisation et passage à l'échelle. Avec une grille de décision, le côté concret côté Symfony (résolution du tenant par le host, filtre Doctrine en pooled, bascule de connexion DBAL en silo), un rappel que l'isolation ne s'arrête pas à la base mais s'étend aux fichiers et au stockage objet, au cache, à la recherche et aux files de messages, trois cas terrain anonymisés positionnés sur l'axe d'isolation, et un parti pris assumé : l'isolation par construction dès que les données sont sensibles.

Technique · Développement · Architecture · · 12 min

Mettre une API externe en cache sans servir de données périmées

Beaucoup d'applications dépendent d'une API qu'elles ne maîtrisent pas — un annuaire, un référentiel, un ticketing maison — lente et parfois indisponible. Le réflexe est de mettre un cache devant ; le piège est de cacher sans discernement et de servir des tickets fermés comme ouverts. Ce retour d'expérience montre que cacher une API externe n'est pas un problème de cache mais de classification : trier chaque donnée entre ce qui peut vieillir (l'annuaire) et ce qui doit rester vivant (les tickets). Avec, autour de cette décision, une façade qui centralise les appels — une couche anti-corruption —, une clé de cache normalisée par tri avant hachage, une dégradation gracieuse qui renvoie une valeur neutre quand l'API tombe, et une interface qui rend toute la chaîne testable hors-ligne.

Technique · Développement · Architecture · · 12 min

Un transport Symfony Mailer sur mesure pour une API d'emails interne

En grande entreprise, le SMTP direct est fermé : tous les emails passent par une API maison, authentifiée en OAuth2 et capable de signer ou chiffrer en S/MIME. Le réflexe est d'écrire un service qui appelle cette API partout — et de coupler cinquante endroits du code à une plomberie spécifique, en perdant au passage l'objet Email, les templates Twig et la file d'attente. Ce retour d'expérience montre le bon point d'extension : un transport Symfony Mailer derrière un DSN api://, qui traduit l'Email en payload, met son token OAuth2 en cache avec une marge et un retry sur 401, et reçoit ses options de signature par des en-têtes MIME consommés en chemin. Une centaine de lignes isolées dans la librairie partagée, et tout le code métier ignore que l'API existe.

Technique · Développement · Architecture · · 12 min

Un moteur de formules métier sans Excel ni eval()

« Il nous faudrait juste des formules, comme dans Excel. » Cette demande mène soit à eval() et ses failles, soit à un parseur maison ingérable — soit à Symfony ExpressionLanguage, un composant discret qui fait exactement ce travail. Ce retour d'expérience croise deux mises en production très différentes : une application de reporting d'un grand opérateur télécom qui a remplacé un classeur Excel — fonctions null-safe à la sémantique tableur, solveur itératif de vingt lignes qui converge sans graphe de dépendances — et une plateforme SaaS PIM où les utilisateurs écrivent eux-mêmes leurs règles — vocabulaire métier de soixante fonctions, validation à la saisie, cache d'AST partagé et dépendances déduites de l'arbre syntaxique. Avec, en fil rouge, la frontière que ce montage offre au métier : changer ses règles sans déploiement.

Contact

Un sujet vous intéresse ?

Vous avez une question technique ou souhaitez approfondir un sujet abordé dans ces articles ? N'hésitez pas à me contacter pour en discuter.

Me contacter arrow_forward